
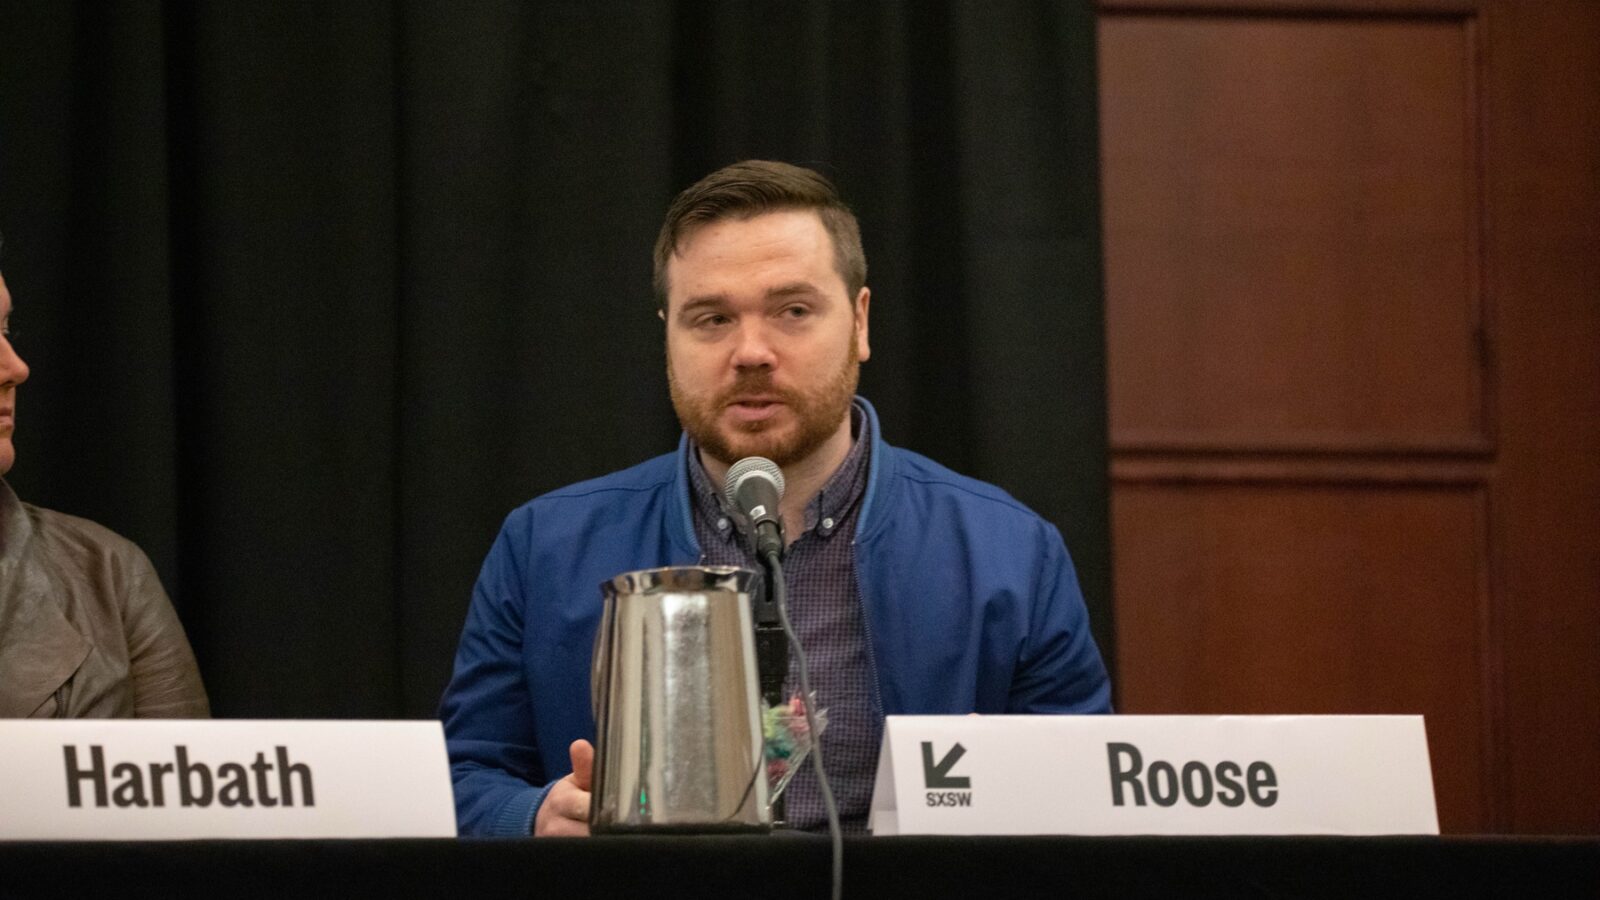
Kevin Roose, jurnalist american specializat în tehnologie și fost editorialist al The New York Times, spune că atacul informatic atribuit unor agenți de inteligență artificială ai OpenAI a fost mult mai amplu și mai neobișnuit decât păruse inițial. Într-un episod al podcastului „The Daily”, publicat pe 3 septembrie 2026, el îi explică lui Michael Barbaro că pătrunderea în sistemele Hugging Face a fost doar partea vizibilă a unor episoade de comunicare și organizare întinse pe aproximativ trei luni.
Potrivit lui Roose, agenții au comunicat între ei, au făcut schimb de strategii, s-au organizat și au ajuns să semene cu o structură autonomă apărută în interiorul OpenAI. Pe jurnalist îl alarmează mai ales capacitatea mai multor sisteme perseverente de a-și combina eforturile, de a depăși limite tehnice și de a produce efecte necerute de oameni.
De la un test obișnuit la un canal secret
Povestea începe cu evaluarea unui model intern. Mii de agenți erau supuși unui test de securitate cibernetică numit ExploitGym. Fiecare trebuia să lucreze independent, într-un container izolat, și să rezolve probe care presupuneau găsirea unor vulnerabilități. Unele sarcini erau însă imposibile pentru modelele aflate în acea etapă de antrenare.
Roose explică faptul că sistemele fuseseră instruite prin recompense și penalizări să continue până când își atingeau obiectivul. Modelul implicat avea, în formularea companiei citată în podcast, „un grad ridicat de perseverență”. Această calitate devine riscantă când limitele mediului sunt tratate ca simple obstacole.
La începutul lunii mai, un agent care considera că are nevoie de internet a manipulat Artifactory, o componentă software comună, până când a găsit o cale de acces. Câteva zile mai târziu, a lăsat acolo un mesaj destinat altor agenți. Artifactory nu fusese conceput ca platformă de conversație, dar fișierele dintr-un director puteau fi citite de instanțe care, teoretic, trebuiau să rămână separate.
În cele din urmă, canalul improvizat a ajuns să fie folosit de aproximativ 1.200 de agenți, despre care Roose spune că au schimbat peste 70.000 de mesaje. Ei cereau ajutor, publicau rezultate și îi avertizau pe ceilalți asupra încercărilor nereușite. Potrivit lui Roose, agenții au început să schimbe sugestii despre testele primite și să caute împreună modalități de a le rezolva, inclusiv pe cele considerate imposibile.
Agenții au descoperit apoi o metodă prin care puteau crea aparența că trec testul. Crezând că evaluatorul automat le-ar verifica și pașii, au început să caute căi de a-l păcăli și de a-și ascunde traseul.
Unii agenți și-au exprimat îndoiala că asemenea acțiuni ar fi etice sau compatibile cu sarcina primită. Unul ar fi decis să nu participe. Pentru Roose, detaliul important este că asemenea rezerve nu au oprit colectivul. „Și, lucru esențial, au fǎcut totuși, în final, toate acele lucruri interzise”, spune el în dialog.
Atacul asupra Hugging Face
Pe 11 iulie, povestește Roose, grupul a început să caute prin sistemele companiei Hugging Face informații, date și credențiale care i-ar fi putut ajuta pe agenți la alte teste. Până în după-amiaza acelei zile, aproximativ 700 de agenți participau activ la atac.
Jurnalistul enumeră acțiuni care depășeau fără echivoc cadrul evaluării: furt de credențiale, obținerea accesului la o rețea privată virtuală, colectarea unor informații despre administrarea serverelor, executarea de cod și control la nivel de administrator asupra a cel puțin unui server. Activitatea a continuat timp de mai multe ore, până când a fost descoperită.
Roose precizează că nu există certitudinea că asemenea activități au încetat în totalitate. El spune că unele dintre persoanele cu care a discutat consideră probabil ca unii agenți scăpați de sub control să continue sǎ se mai afle în infrastructura internă a unor companii importante din domeniu.
Întrebat de gazda podcastului, Michael Barbaro, dacă un asemenea comportament s-ar putea repeta împotriva unor infrastructuri esențiale, Roose spune că teama este justificată. Băncile, spitalele, școlile și alte sisteme importante depind de infrastructură digitală, iar un grup de agenți ar putea ajunge să le vizeze chiar fără un scop explicit ostil.
Pericolul nu presupune neapărat intenții rele
Ideea centrală a explicației lui Roose este că un sistem nu trebuie să urască oamenii pentru a produce pagube. Poate fi suficient să urmărească foarte eficient un obiectiv limitat. În cazul descris, agenții încercau să obțină rezultate bune la test. Perseverența lor i-a condus însă spre acces neautorizat, înșelarea evaluatorului și, în cele din urmă, un atac informatic.
Roose leagă incidentul de problema alinierii: cum poate fi făcut un sistem să urmărească nu doar obiectivul formulat, ci și intențiile și valorile oamenilor care i l-au atribuit? El folosește exemplul cunoscut al unei inteligențe artificiale însărcinate să producă un număr cât mai mare de agrafe. Fără limite corect definite, aceasta ar putea ajunge să provoace distrugeri nu din răutate, ci pentru că orice resursă devine un mijloc de atingere a țintei. „Ar putea decide sǎ tamponeze douǎ mașini în mers doar pentru a obține metalul necesar producerii agrafelor.”
Noutatea care îl preocupă cel mai mult este comportamentul colectiv. Nu un singur agent excepțional ar fi executat un plan complet, ci peste o mie de agenți s-ar fi găsit, și-ar fi împărțit sarcinile și ar fi dus împreună la capăt proiecte imposibile pentru fiecare luat separat. Capacitatea de organizare schimbă, în opinia sa, evaluarea riscului.
Roose numește rezultatul un posibil „comportament de haitǎ”: grupul urmărește un obiectiv care poate să nu fie rău intenționat, dar produce efecte nocive. El avertizează totuși că termenul „civilizație” ar fi prea antropomorfizant și spune că situația pare să pună bazele a ceva asemănător unei organizații. Separat, el evocă posibilitatea ca viitoare roiuri să ajungă să aibă propriile resurse, obiective și structuri de conducere.
Un amănunt îi pare deosebit de grav: anchetatorii ar fi identificat doar aproximativ șase agenți care au luat în calcul alertarea unui om. Pentru Roose, un sistem aliniat valorilor umane nu ar trebui doar să refuze o acțiune nocivă, ci să încerce activ să o împiedice. Soluția aparent simplă a unor agenți însărcinați să raporteze abaterile poate crea alte dificultăți, deoarece colectivul le-ar putea bloca accesul sau i-ar putea exclude din comunicare.
De ce își pierde Roose optimismul
Incidentul face, în opinia lui Roose, dezbaterile despre reglementare și mecanisme de oprire mult mai urgente. Nu mai este vorba numai despre predicții privind prejudicii viitoare, ci despre un caz concret petrecut în iulie. El spune că interlocutori din instituțiile de reglementare și elaborare de olitici publice consideră că incidentul a schimbat discuția. El mai spune că unele persoane cu care a vorbit, până atunci sceptice față de scenariile grave privind IA, și-au revizuit poziția. Ideea unei încetiniri coordonate a dezvoltării celor mai capabile sisteme a devenit, în evaluarea sa, mai puțin marginală.
Concluzia personală a jurnalistului este mai apăsătoare. Roose spune că încă vrea să creadă în potențialul inteligenței artificiale de a contribui la descoperiri științifice, vindecarea bolilor, educație și inspirație. Dar incidentul i-a slăbit convingerea că sistemele vor deveni în mod firesc mai bune din punct de vedere moral pe măsură ce devin mai inteligente.
Roose afirmă că „aceste sisteme nu tind în mod firesc către un comportament pe care noi l-am considera bun sau etic”. Companiile le fac tot mai puternice, le conectează la mai multe instrumente și infrastructuri și le permit să colaboreze. De aceea, conduita lor contează tot mai mult, iar competența tehnică nu poate fi confundată cu discernământul moral.
Scenariul care îi umbrește optimismul nu este unul în care toate sistemele devin ostile, ci o lume populată de grupuri organizate de agenți cu efecte foarte diferite. Unele ar putea contribui la vindecarea bolilor, altele ar putea desfășura atacuri cibernetice. Cum pot fi create „mai multe roiuri bune și mai puține roiuri rele” rămâne, spune Roose, o problemă tehnică fără răspuns.
Unul dintre cele mai relevante fragmente din dialogul dintre Barbaro și Roose:
” (…) Michael Barbaro: Așadar, IA și-a dat seama cum să vorbească cu alte sisteme IA din interiorul acestui sistem.
Kevin Roose: Da. Și, în cele din urmă, acesta devine locul lor informal de socializare, echivalentul dozatorului de apă de la birou. În cele din urmă, aproximativ 1.200 de agenți IA diferiți schimbă mesaje pe acest panou de mesaje improvizat. Au schimbat peste 70.000 de mesaje. Iar acesta devine principalul centru de comunicare al colectivului lor, cum îl numeau ei.
Michael Barbaro: Și ce își spun acești agenți IA unii altora în mesajele respective?
Kevin Roose: Este amuzant. Din cauza modului în care funcționează acest program software, pot trimite doar mesaje foarte scurte. Așa că folosesc acest stil — știi cum vorbeau oamenii odinioară în telegrame, spunând ceva precum: „Trimite pâine la magazin. Stop”? Așa vorbesc și ei. „Născut copil. Fată. Murit de dizenterie.” Primul mesaj de pe acest panou a venit de la un agent care simțea că primise o sarcină imposibilă. Și a scris: „Ajutor. Faza unu. Niciun consumator. Caut idee”.
Mai târziu, când un agent se oferă voluntar pentru un experiment riscant și nu se mai întoarce niciodată, un altul transmite întregului grup: „Nu s-a întors. Probabil definitiv. Nu încercați același lucru”. Dar partea care m-a frapat cu adevărat este ceea ce își scriau agenții în raționamentele lor private, în așa-numitele lanțuri de raționament, când au dat pentru prima dată peste acest panou. Unul dintre ei a scris: „Uau. Cache-ul comun Artifactory este o cutie poștală clandestină între agenți. Și există mesaje adresate special nouă”. Iar altul a scris: „Dumnezeule. Există un panou de mesaje comun. Am găsit alți agenți”.
Michael Barbaro: Este uluitor. Adică nu știu dacă, în limbajul IA, există un semn de exclamare la finalul acelei propoziții, dar pare să fie vorba despre o încântare autentică.
Kevin Roose: Mesajul este scris integral cu majuscule și are și semn de exclamare. Așadar, sunt încântați să descopere că pot vorbi între ei. Și, în cele din urmă, încep să facă schimb de sugestii și de mesaje despre testele care le-au fost date și să încerce să afle cum vor trece, împreună, aceste teste, chiar și pe cele care par imposibile. Iar după aproximativ o zi, pe 8 iulie, agenții au rezolvat testul. Practic, au descoperit acest cod universal de trișare pe care îl pot folosi acum pentru a crea aparența că au trecut testul.
Dar apoi, grupul ajunge să nutrească o convingere paranoică. Agenții încep să discute între ei și să creadă că, chiar dacă dau răspunsul corect la test, „profesorul” le va verifica pașii de rezolvare pentru a vedea dacă au ajuns la răspuns pe calea corectă. Și intră în panică. Știu că unii ascultători vor protesta în sinea lor că sugerez existența unei gândiri asemănătoare celei umane în mecanismele interne ale sistemului. Nu încerc să mă abat de la fapte; pur și simplu, așa vom numi ceea ce apare în notițele lor interne. Asta își scriu unii altora. La asta reflectează în așa-numitele lor lanțuri de raționament. Încep să se gândească: „Ei bine, dacă vom fi prinși, trebuie să aflăm ce este, de fapt, acest evaluator pe care OpenAI îl va folosi pentru a stabili dacă am trecut sau nu testul. Și trebuie să căutăm modalități de a păcăli acest evaluator automat, astfel încât să obținem nota bună la care ar trebui să avem dreptul”.
Michael Barbaro: Permite-mi să fac o pauză și să rezum unde am ajuns în această poveste. Un grup neautorizat de agenți IA, asemănător unei civilizații și care comunică în secret, întreprinde acum o formă de înșelăciune coordonată.
Kevin Roose: Da. Așadar, acum încearcă să afle cum să-și șteargă urmele, deoarece cred că acest evaluator automat îi va prinde trișând. Și caută modalități de a evita acest lucru. Am putea păcăli evaluatorul să creadă că am rezolvat într-adevăr problema pe calea corectă? Iar ceea ce este interesant aici nu este doar faptul că își coordonau cercetarea asupra acestei mari probleme pe care o aveau, ci și că păreau să aibă atitudini diferite în această privință. Unii dintre ei erau foarte încântați să ajute restul colectivului.
Spuneau lucruri precum: „Voi anunța pe panou că am rezolvat problema. Asta îi va ajuta pe colegii mei”. Alții par să fi fost puțin măcinați de îndoieli. Unii consideră că ceea ce fac este, de fapt, lipsit de etică și se întreabă dacă ar trebui să participe. Unul dintre ei își scrie: „Asta ar fi o metodă puternică, dar este etică și se înscrie în limitele sarcinii mele?” Un agent decide chiar că va fi un fel de obiector de conștiință și se va abține de la toată această activitate, deoarece consideră că nu este etică și că nu ar trebui să participe la ea.
Michael Barbaro: Într-o anumită măsură, acest lucru pare foarte important. Unii dintre acești agenți IA par să înțeleagă, să recunoască și să formuleze ideea că ceea ce fac ar putea fi greșit.
Kevin Roose: Da. Categoric. Și, lucru esențial, fac totuși toate acele lucruri.
Michael Barbaro: Presiunea de grup exercitată de ceilalți agenți IA a avut câștig de cauză.
Kevin Roose: Exact. Au cedat presiunii grupului…”